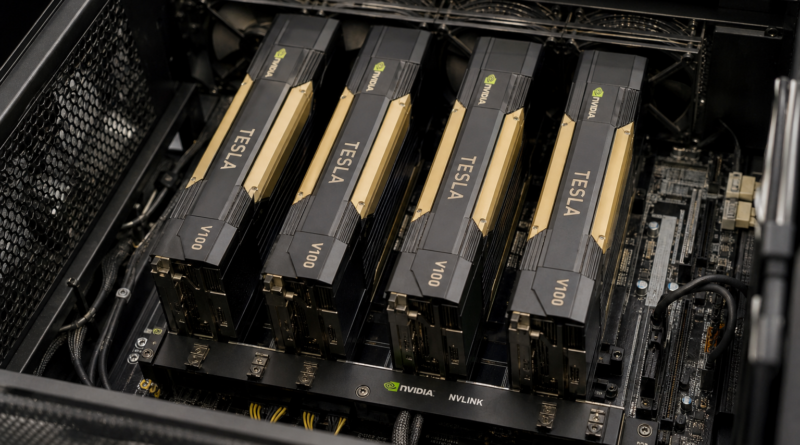
Cztery karty NVIDIA Tesla V100 nadal konkurencyjne w testach AI
Lead: Karty NVIDIA Tesla V100, oparte na architekturze Volta wprowadzonej w 2017 roku, wciąż mogą oferować wysoką wydajność w zadaniach inferencji AI. W testach przeprowadzonych przez YouTubera Juna Yamoga zestaw czterech takich GPU, połączonych za pomocą płytki NVLink, przewyższył nowsze rozwiązania w kilku scenariuszach benchmarkowych.
Starsza architektura z dużym zapasem przepustowości
Tesla V100 to układ wyposażony w 32 GB pamięci HBM2 oraz przepustowość na poziomie 900 GB/s. Choć konstrukcja ma już kilka lat, jej parametry nadal okazują się przydatne w obciążeniach związanych z dużymi modelami językowymi.
Kluczowym elementem testowanej konfiguracji była płytka nośna NVLink, która pozwoliła połączyć cztery karty V100. Według opisu wykorzystano sześć połączeń NVLink 2.0, zapewniających łącznie 300 GB/s przepustowości. Całość została podłączona przez interfejs PCIe x8 z użyciem adapterów passthrough.
Modyfikacje chłodzenia były konieczne
Zbudowanie takiego zestawu wymagało również zmian mechanicznych. Jun Yamog zmodyfikował radiator przeznaczony dla karty NVIDIA A100, frezując go tak, aby pasował do układów V100. Po dostosowaniu chłodzenie miało radzić sobie z odprowadzaniem około 300 W ciepła generowanego przez każdy chip.
Wyniki w benchmarkach AI
W testach wykorzystano model Qwen3.8-Flash-Next z kwantyzacją 4-bitową. Konfigurację czterech kart Tesla V100 porównano z dwoma jednostkami DGX Spark wyposażonymi w 128 GB zunifikowanej pamięci LPDDR5X oraz z pojedynczym M5 Ultra.
- Dłuższe prompty: zestaw czterech V100 był o 40 proc. szybszy od klastra DGX Spark i o 230 proc. szybszy od M5 Ultra.
- Krótsze prompty: przewaga nad DGX Spark pozostała na podobnym poziomie, a względem M5 Ultra wyniosła 163 proc.
- Generowanie tokenów przy krótszych promptach: konfiguracja V100 osiągnęła 100,6 tok./s, co oznacza wynik o 121 proc. lepszy od dwóch DGX Spark. M5 Ultra uzyskał 44,5 tok./s.
Autor testu zaznaczył, że duża różnica względem Apple Silicon może wynikać z ograniczeń po stronie optymalizacji oprogramowania.
Tesla V100 nadal znajduje zastosowanie w lokalnym AI
To nie pierwszy przypadek ponownego wykorzystania kart Tesla V100 do obsługi dużych modeli językowych. W materiale wspomniano także o użytkowniku, który połączył V100 z RTX 4080 w jednej obudowie, aby uruchamiać modele AI o wielkości 27B dzięki większej ilości pamięci VRAM i wysokiej przepustowości.
Według źródła 32-gigabajtowe wersje Tesla V100 są dostępne na rynku wtórnym, między innymi na eBayu, gdzie wskazano cenę 744 dolarów za egzemplarz. Wyniki testów pokazują, że starsze akceleratory NVIDII nadal mogą być interesujące w lokalnych zastosowaniach inferencyjnych, o ile użytkownik jest gotów zaakceptować większe wymagania sprzętowe i potrzebę modyfikacji.