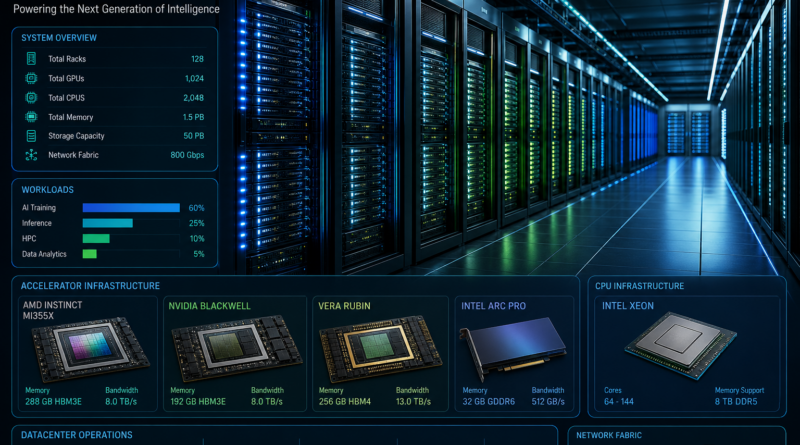
MLPerf Inference 6.1: AMD pokazuje klaster 512 GPU MI355X, NVIDIA debiutuje z Vera Rubin, a Intel zgłasza Xeony i Arc Pro
MLCommons opublikowało wyniki MLPerf Inference v6.1, obejmujące najnowsze zgłoszenia AMD, NVIDII i Intela w testach związanych z obciążeniami AI. Największą uwagę zwrócił klaster AMD z 512 akceleratorami Instinct MI355X, pierwsze wyniki platformy NVIDIA Vera Rubin oraz obecność rozwiązań Intel Xeon i Arc Pro B70.
AMD stawia na skalę z Instinct MI355X
W testach DeepSeek R1 AMD zgłosiło największą dotąd konfigurację klastra złożoną z 512 układów Instinct MI355X. System ten uzyskał najwyższe wyniki zarówno w scenariuszu offline, jak i server. Podobnie wyglądała sytuacja w przypadku GPT-OSS 120B, gdzie ta sama skala konfiguracji również znalazła się na czele zestawienia.
Według danych przytoczonych przy zgłoszeniu AMD, w konfiguracji 512 GPU osiągnięto 5,75 mln tokenów na sekundę w trybie Offline dla GPT-OSS 120B oraz 2,90 mln tokenów na sekundę dla DeepSeek-R1. Firma podkreśliła również wpływ dalszych optymalizacji oprogramowania ROCm na wyniki uzyskiwane przez ten sam sprzęt.
NVIDIA utrzymuje mocną pozycję dzięki Blackwell i pokazuje Vera Rubin
NVIDIA zgłosiła wyniki systemów GB300 i GB200, w tym konfiguracji liczących 288 GPU. W DeepSeek R1 układ GB300 zbliżył się do rezultatu platformy AMD MI355X, choć przy mniejszej liczbie akceleratorów.
Istotnym elementem publikacji MLPerf Inference v6.1 był pierwszy podgląd wyników platformy NVIDIA Vera Rubin, oznaczonej jako VR200. W testach pojawiły się konfiguracje 72- i 36-GPU. W przypadku DeepSeek R1 system VR200 z 72 GPU był do 95 proc. szybszy od konfiguracji GB300 z taką samą liczbą GPU, a wariant 36-GPU wyprzedził konfigurację GB200 z 72 GPU.
NVIDIA poinformowała także, że system Vera Rubin NVL72 w pierwszym zgłoszeniu poglądowym MLPerf Inference osiągał do 3,7 raza wyższą przepustowość niż GB300 NVL72. Firma wskazała również na skalowanie GB300 NVL72: zgłoszenie z 288 GPU w czterech szafach miało uzyskać 99 proc. efektywności skalowania.
Różne wyniki w zależności od modelu i skali
W testach GPT-OSS 120B AMD prowadziło przy największej, 512-GPU konfiguracji. W segmentach 72 i 8 GPU bardzo mocnie wypadły systemy NVIDIA GB300, natomiast AMD MI350P okazało się szybsze od MI300X w konfiguracjach 8-GPU.
W Llama 2 70B przewagę w konfiguracjach 72-GPU miały rozwiązania NVIDIA Blackwell. GB300 wyprzedzał także MI355X w konfiguracji 8-GPU, choć platforma AMD była szybsza od GB200 w tym samym segmencie. W Llama 3.1-8B konfiguracja NVIDIA GB300 z 8 GPU była do 17 proc. szybsza od 8-GPU AMD MI355X.
Intel rozszerza udział Xeonów i pokazuje Arc Pro B70
Intel również znalazł się w zestawieniu MLPerf Inference v6.1. Firma rozszerzyła udział procesorów Xeon 6: w porównaniu z poprzednią rundą liczba testowanych jednostek SKU wzrosła z dwóch do pięciu, a liczba wyników CPU inference z 24 do 35. Według Intela Xeon pozostaje jedynym samodzielnym serwerowym CPU reprezentowanym w zgłoszeniach MLPerf Inference.
Wyniki obejmowały także Intel Arc Pro B70. Pojedynczy system z czterema takimi kartami oferował 128 GB pamięci VRAM i został zgłoszony w zadaniach obejmujących m.in. Llama 3.1 8B, Llama 2 70B, GPT-OSS-120B, Whisper oraz E2E-RAG. Na tej samej czterokartowej konfiguracji co w MLPerf v6.0 wydajność GPT-OSS-120B Server wzrosła o 36 proc., a Offline o 27 proc.
Najważniejsze wnioski z MLPerf Inference v6.1
- AMD pokazało bardzo wysoką wydajność w największej konfiguracji 512 GPU Instinct MI355X, szczególnie w DeepSeek R1 i GPT-OSS 120B.
- NVIDIA utrzymała silną pozycję dzięki GB300 i GB200 oraz zaprezentowała pierwsze wyniki platformy Vera Rubin.
- Intel zwiększył liczbę zgłoszeń Xeon 6 i zaprezentował wyniki Arc Pro B70 w zadaniach AI.
- Oprogramowanie pozostaje kluczowym czynnikiem, ponieważ wszystkie firmy wskazują na dalsze wzrosty wydajności wynikające z optymalizacji stosu programowego.
MLPerf Inference v6.1 pokazuje, że rywalizacja w akceleracji AI nie ogranicza się do jednego producenta ani jednej klasy sprzętu. Wyniki zależą od modelu, skali konfiguracji oraz dojrzałości oprogramowania, a kolejne rundy testów mogą przynieść zauważalnie inne rezultaty.